Arquitetura serverless: entenda como funciona na prática
Otimize seus custos de infraestrutura e elimine a gestão de servidores adotando a arquitetura serverless em projetos modernos.
Anúncios
Imagine um sistema que recebe milhares de acessos em poucos minutos e, logo depois, passa horas quase sem atividade. Em uma infraestrutura tradicional, a equipe precisa prever essa variação e manter servidores disponíveis. Com a arquitetura serverless, os recursos podem acompanhar a demanda, enquanto a operação da infraestrutura fica, em grande parte, a cargo do provedor de nuvem.
O nome pode sugerir que não existem servidores, mas eles continuam presentes. A diferença está em quem cuida deles e em como a capacidade é alocada. Entender essa distinção ajuda a avaliar quando esse modelo simplifica o desenvolvimento — e quando seus limites exigem atenção.
O que significa arquitetura serverless
Arquitetura serverless é uma forma de criar e executar aplicações sem que a equipe precise provisionar e administrar diretamente os servidores subjacentes. O provedor de nuvem mantém a infraestrutura, distribui a capacidade e, em geral, cobra com base no uso de determinados serviços.
Isso não significa que o sistema deixa de depender de máquinas físicas ou virtuais. Significa que tarefas como configuração de servidores, aplicação de atualizações e ajuste de capacidade são abstraídas para quem desenvolve a aplicação. A equipe pode concentrar mais esforço na lógica do produto, embora ainda precise planejar segurança, disponibilidade e custos.
O modelo costuma combinar serviços gerenciados com execução acionada por eventos. Uma função pode rodar quando chega uma solicitação, um arquivo é enviado, uma mensagem entra em uma fila ou um evento é registrado em um banco de dados. Assim, em vez de manter um processo ligado sem interrupção, a aplicação responde a acontecimentos específicos.
Como funciona na prática
Considere uma loja virtual que recebe uma imagem de produto. O upload pode disparar um evento de armazenamento; esse evento inicia uma função que redimensiona a imagem e grava as versões em outro local. Ao final, a função encerra sua execução, sem que a equipe precise manter um servidor dedicado à tarefa.
Um fluxo comum também pode começar com uma solicitação HTTP. Uma porta de entrada, como um serviço de API, recebe a chamada e encaminha os dados para uma função. Essa função valida a solicitação, consulta um banco de dados ou outro serviço e devolve uma resposta ao cliente.
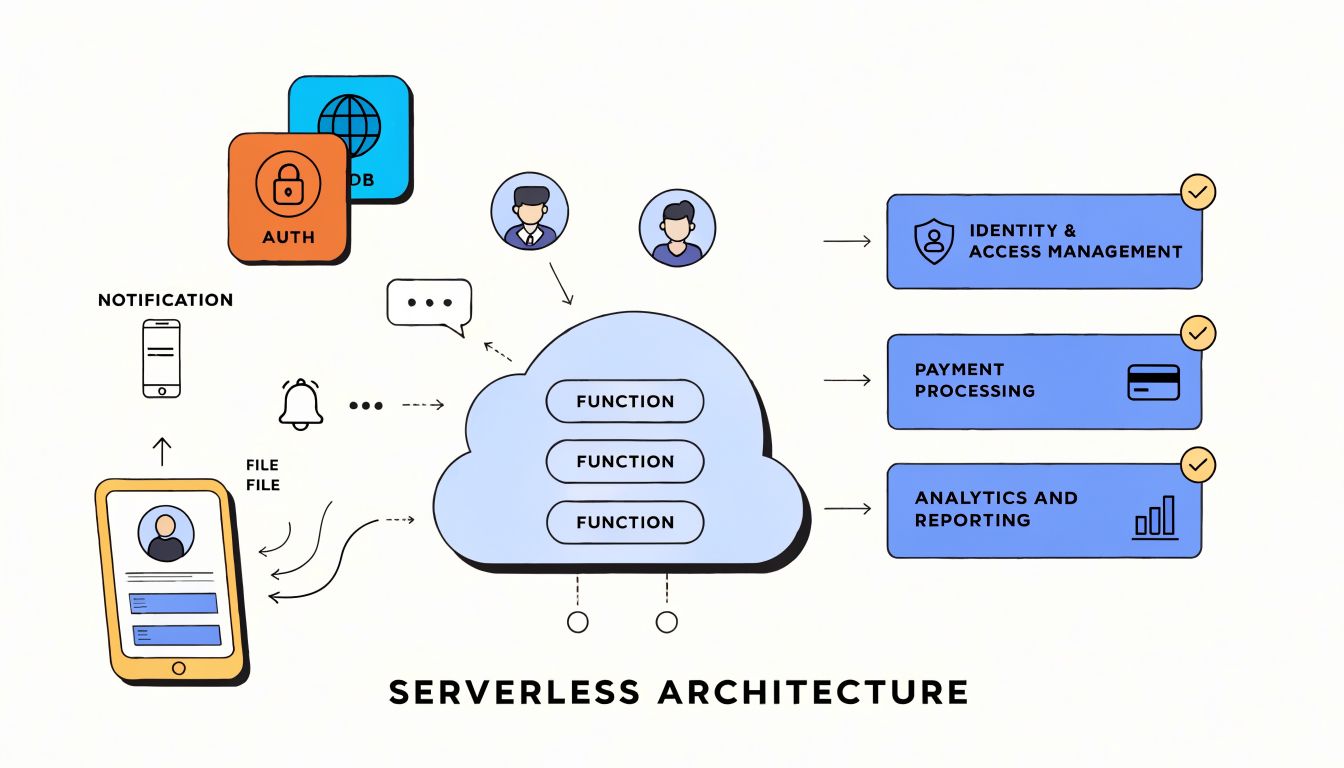
A arquitetura, portanto, não é apenas uma coleção de funções. Ela pode incluir autenticação, filas, armazenamento de arquivos, bancos de dados, serviços de notificação e ferramentas de monitoramento. O desenho conecta esses componentes para que cada um execute uma responsabilidade bem definida, muitas vezes em resposta a eventos.
Essa organização favorece o desacoplamento. Se o envio de notificações ficar lento, por exemplo, uma fila pode armazenar as mensagens enquanto outros componentes continuam trabalhando. A fila também permite processar tarefas gradualmente e repetir tentativas quando uma falha temporária ocorre.
FaaS e BaaS: dois conceitos relacionados
A execução de funções é frequentemente chamada de FaaS, sigla para Function as a Service. Nesse modelo, o código é dividido em unidades que são executadas sob demanda, dentro de limites definidos pelo provedor. AWS Lambda, Azure Functions e Google Cloud Functions são exemplos conhecidos de serviços dessa categoria.
Já BaaS, ou Backend as a Service, reúne serviços prontos de backend, como autenticação, bancos de dados, armazenamento e notificações. Em vez de implementar e manter cada componente, a aplicação consome serviços gerenciados por meio de APIs ou bibliotecas. FaaS e BaaS podem ser combinados, mas não são sinônimos: um descreve a execução de código e o outro, o uso de capacidades de backend oferecidas como serviço.
Uma aplicação serverless pode usar apenas alguns desses elementos. Por exemplo, uma equipe pode manter partes de um sistema em contêineres e usar funções para tarefas de processamento eventual. A escolha não precisa ser absoluta; arquiteturas híbridas são comuns quando combinam melhor com as necessidades do produto.
Vantagens e situações favoráveis
Uma das vantagens mais atraentes é a escalabilidade automática. Quando muitas solicitações chegam ao mesmo tempo, o provedor pode iniciar execuções em paralelo, dentro das cotas e configurações disponíveis. Em períodos de baixa atividade, a aplicação pode consumir menos recursos do que uma infraestrutura dimensionada para o pico máximo.
O modelo também reduz parte do trabalho operacional. A equipe não precisa administrar cada servidor de execução, o que pode liberar tempo para desenvolver funcionalidades e melhorar a experiência dos usuários. Para projetos novos, protótipos e cargas variáveis, essa simplificação pode facilitar experimentos sem exigir a construção antecipada de uma infraestrutura extensa.
A cobrança por uso pode ser vantajosa quando a demanda é irregular ou quando as funções são executadas por períodos curtos. Em vez de pagar continuamente pela capacidade reservada, certos serviços cobram por chamadas, duração ou recursos consumidos. No entanto, o resultado financeiro depende do padrão de tráfego, do desenho da solução e dos preços específicos de cada provedor.
Imagine um serviço que gera relatórios uma vez por dia e recebe poucos pedidos de forma imprevisível. Uma função acionada por solicitação pode ser mais adequada do que manter uma máquina ativa o tempo todo. Já um processamento contínuo e intenso pode exigir uma comparação detalhada com outras opções de hospedagem.
Limitações e desafios que merecem atenção
A abstração da infraestrutura não elimina a complexidade; em alguns casos, ela a desloca. Uma aplicação formada por muitas funções pequenas pode ser difícil de acompanhar se não houver uma visão clara dos fluxos, das dependências e dos pontos de falha. O rastreamento de uma solicitação que passa por vários serviços exige logs correlacionados e ferramentas de observabilidade bem configuradas.
Outro aspecto é o chamado cold start, ou inicialização a frio. Se uma função ficar sem uso por certo período, o provedor pode precisar preparar um ambiente antes de executá-la. Isso pode adicionar latência, especialmente em aplicações sensíveis ao tempo de resposta. A frequência desse efeito varia conforme o serviço, a configuração, a linguagem e o padrão de uso.
Funções também podem ter limites de duração, memória e concorrência. Tarefas muito longas ou que dependem de processamento contínuo talvez se encaixem melhor em contêineres, máquinas virtuais ou serviços especializados. Antes de escolher, é importante comparar os requisitos da carga com os limites do provedor e considerar como a aplicação se comportará em situações de pico.
O controle de custos exige acompanhamento. Muitas execuções curtas podem parecer baratas individualmente, mas o volume, o tráfego entre serviços e o uso de armazenamento podem elevar a fatura. Alertas de orçamento, métricas de consumo e testes com cenários realistas ajudam a evitar surpresas. Também é prudente compreender como os preços mudam entre regiões e provedores.
Segurança, disponibilidade e observabilidade
Em um sistema serverless, a segurança depende de permissões bem delimitadas. Cada função deve receber apenas o acesso necessário para realizar sua tarefa. Uma função que redimensiona imagens, por exemplo, não deveria ter permissão irrestrita para alterar dados financeiros ou administrar todos os recursos da conta.
As configurações de rede, o gerenciamento de segredos e a validação das entradas continuam sendo responsabilidades importantes. O provedor protege a infraestrutura que administra, mas a equipe ainda precisa proteger o código, as identidades, os dados e as regras de acesso da aplicação. Esse princípio de responsabilidades compartilhadas varia em detalhes, por isso convém consultar a documentação do serviço utilizado.
A observabilidade deve ser pensada desde o início. Métricas revelam volume, duração e erros; logs mostram o que ocorreu durante uma execução; e rastreamentos ajudam a entender o caminho de uma solicitação entre diferentes componentes. Com essas informações, fica mais fácil identificar gargalos, detectar falhas recorrentes e estimar o impacto de uma mudança.
Também é necessário planejar a recuperação de falhas. Filas podem receber políticas de repetição e encaminhar mensagens problemáticas para uma fila de mensagens não processadas. Ainda assim, repetir uma operação pode gerar efeitos duplicados. Por isso, quando possível, as funções devem ser idempotentes: executar a mesma solicitação mais de uma vez não deve produzir resultados incorretos ou indesejados.
Como decidir se serverless é adequado
A decisão começa pelas características da carga de trabalho. Pergunte com que frequência a aplicação é usada, quanto tempo cada tarefa leva, quão importante é a latência inicial e quais dependências externas estão envolvidas. Também avalie se o time tem experiência com serviços de nuvem e se consegue monitorar o comportamento distribuído da solução.
Em seguida, faça um protótipo com uma parte representativa do sistema. Meça latência, consumo, erros e custo em diferentes níveis de tráfego. Um teste simples pode revelar restrições que não aparecem em uma estimativa teórica, como limites de concorrência ou dependências que tornam uma função mais lenta do que o esperado.
Por fim, considere a dependência de um provedor. Serviços gerenciados podem acelerar o desenvolvimento, mas interfaces e recursos específicos podem dificultar uma migração posterior. Documentar decisões, manter contratos claros entre componentes e evitar dependências desnecessárias ajuda a preservar opções sem abrir mão dos benefícios do serviço escolhido.
Conclusão
A arquitetura serverless permite executar aplicações e tarefas sem administrar diretamente os servidores, usando serviços gerenciados e recursos acionados conforme a demanda. Ela pode simplificar operações, favorecer o escalonamento e alinhar custos ao uso, mas não elimina a necessidade de arquitetura cuidadosa, segurança, monitoramento e controle financeiro.
Na prática, o melhor caminho é avaliar cada carga de trabalho, testar hipóteses e escolher os componentes que atendem aos requisitos reais. Ao explorar a arquitetura serverless com esse olhar crítico, você pode descobrir não apenas como reduzir tarefas operacionais, mas também novas formas de organizar e evoluir seus sistemas.